IT3212 Assignment 4: Q-learning vs PPO su Breakout
Gruppo 13 · Riassunto di cosa è stato fatto, da leggere prima del meeting di giovedì 19 novembre alle 11:00 (circa 10 minuti).
1. Da zero: di cosa parla il compito
Facciamo finta di consigliare un team che vuole un agente di reinforcement learning (RL) per un ambiente incerto, con poche risorse di training. Dobbiamo dire quale approccio usare in tre situazioni diverse. Vince la raccomandazione meglio difesa, anche se gli agenti giocano male.
Cos'è il RL. Un agente prova delle azioni in un ambiente e riceve una ricompensa. Non c'è un dataset: impara giocando quali azioni portano più ricompensa nel tempo.
Il gioco. Atari Breakout: una racchetta (paddle) in basso, una palla, dei mattoncini in alto. Abbiamo dato al gioco un obiettivo semplice:
- Successo: fare 5 punti prima di perdere la prima palla.
- Fallimento: perdere la palla prima.
- Timeout: nessuna delle due dopo 1.000 step (non è mai successo).
L'agente vede solo 4 numeri: x e y della palla e x del paddle, letti dalla RAM del gioco (la memoria della console Atari, 128 celle), più la direzione della palla, calcolata dal movimento tra due step. Ha 4 azioni: NOOP (resta fermo), FIRE, RIGHT, LEFT. Riceve +1 per ogni punto.
Q-learning (tabellare)
Divide le situazioni in 169 caselle (distanza palla–paddle, altezza della palla, direzione). Per ogni casella e azione tiene un numero, il Q-value: "quanto vale fare questa azione qui". All'inizio sceglie a caso, poi sempre meno (ε scende da 1.0 a 0.05). Scritto a mano, come nel notebook del corso.
PPO (rete neurale)
Riceve i 4 numeri esatti, senza caselle. Una piccola rete (64×64) dà la probabilità di ogni azione, un'altra parte (il "critico") stima quanto vale la situazione. Riusa ogni pezzo di esperienza più volte (10 epoche). Preso da stable-baselines3.
Le parti del compito. Parte 1: previsioni scritte prima degli esperimenti (già consegnate, non si toccano). Parte 2: confronto in 4 setting. Parte 3: cosa succede cambiando un iperparametro alla volta. Parte 4: analisi di 10 episodi. Parte 5: revisione fatta da noi (da fare, vedi sezione 9). Parte 6: raccomandazioni.
2. Come abbiamo testato
| Setting | Cosa cambia |
|---|---|
| A | Deterministico: stessa azione, stesso risultato. |
| B | Incertezza: con probabilità 0.25 il gioco ignora l'azione e ripete la precedente ("sticky actions"). |
| C | Come B, più una piccola penalità di −0.001 per step (per spingere a finire prima). |
| D | Gli agenti di B, senza nuovo training, giocano con un paddle più piccolo (12 px invece di 16). |
- Budget: 500.000 interazioni (step di gioco) per ogni training. "Budget piccolo" = lo stesso agente fotografato a 100.000.
- Seed: ogni configurazione è allenata 5 volte (seed 0–4). I risultati sono sempre media ± deviazione standard sui 5 agenti, mai episodi mescolati tra seed.
- Valutazione: 200 episodi per agente, con seed mai usati per training o tuning. Q-learning sceglie l'azione con Q-value più alto, PPO l'azione più probabile.
- Tuning equo: 8 configurazioni × 3 seed per ciascun algoritmo, in B, su seed separati.
- Hardware: tutto sul PC Ubuntu (i9-14900, 32 thread), solo CPU, 32 run in parallelo. Il comando unico è in
README.md.
3. Risultati principali (Parte 2)
| Setting | Q successo | PPO successo | Lettura |
|---|---|---|---|
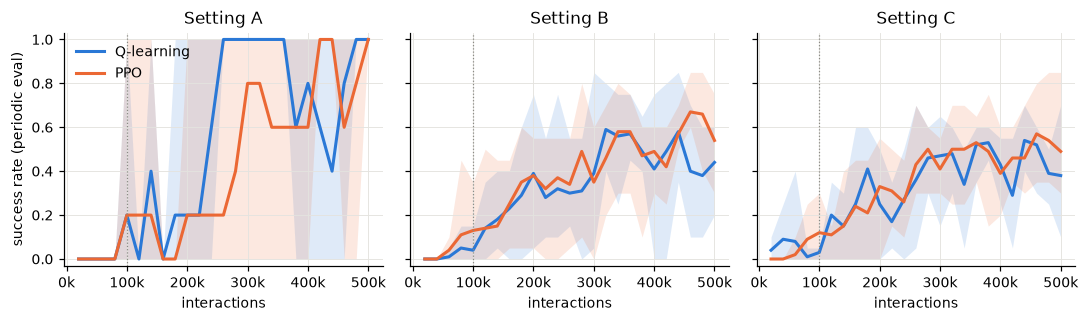
| A, 100k | 0.20 | 0.20 | Solo 1 agente su 5 per tipo ce la fa: pareggio. |
| A, 500k | 1.00 | 1.00 | Tutti e 10 gli agenti risolvono A. |
| B, 500k | 0.46 ± 0.20 | 0.56 ± 0.17 | L'incertezza dimezza il successo. Differenza minore di una std. |
| C, 500k | 0.36 ± 0.15 | 0.60 ± 0.12 | La penalità non aiuta: non c'erano episodi lunghi da accorciare. |
| D, 500k | 0.32 ± 0.18 | 0.46 ± 0.11 | Seed 0–4: calo simile (−0.13 e −0.10). Con seed nuovi 5–9 PPO cala molto di più (0.27 contro Q 0.37): su 10 agenti pari (0.36 e 0.35). |
- Q-learning è più economico in tempo: 1.6–1.8 volte più step al secondo sulla stessa macchina.
- In A tutti i Q-agenti riescono dalla valutazione a 260k, tutti i PPO da 420k. Ma Q non è stabile: scende a 0.4 a 440k.
- In A un agente fa 0 o 1, perché senza casualità gioca sempre lo stesso episodio.
- I seed contano molto: in B gli agenti vanno da 0.22 a 0.72.
runs/main/{A,B,C}.4. Meccanismi (Parte 3)
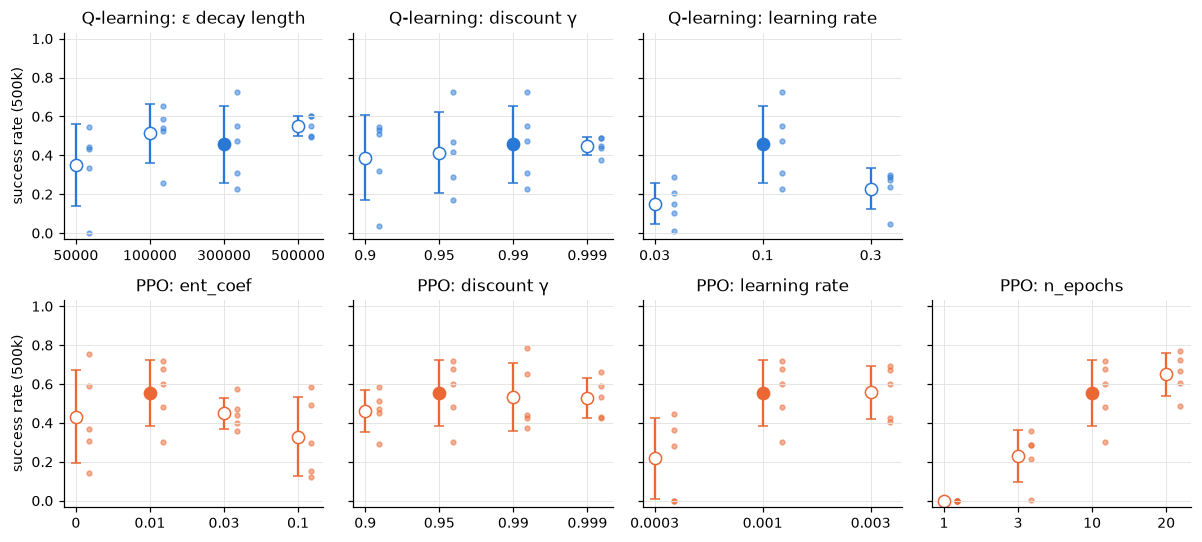
Setting B, 5 seed, un fattore alla volta. Successo a 500k (* = configurazione principale):
- Esplorazione di Q (durata del calo di ε): 50k 0.35, 100k 0.51, 300k* 0.46, 500k 0.55. Con 500k la std è piccola (0.05), ma anche γ 0.999 ha std 0.05: con 5 seed può essere un caso. E a 500k quegli agenti stavano ancora migliorando.
- Orizzonte γ: quasi nessun effetto per entrambi (0.9 → 0.999). Il punto arriva poco dopo la presa, quindi conta la prossima presa.
- Learning rate di Q: picco chiaro a 0.1 (0.03 → 0.15, piatto dopo 400k; 0.3 → 0.23).
- Entropia di PPO: media più alta a 0.01 (0.56), ma 0, 0.01 e 0.03 differiscono meno di una std; 0.1 è la più bassa (0.33). Beneficio debole.
- Learning rate di PPO: 3e-4 troppo lento (0.22), 1e-3 e 3e-3 uguali (0.56).
- Epoche di PPO (riuso dei dati): 1 → 0.00, 3 → 0.23, 10* → 0.56, 20 → 0.65. Più riuso aiuta, e 20 è il bordo della griglia.
runs/mech/B e runs/main/B.L'esperimento diagnostico
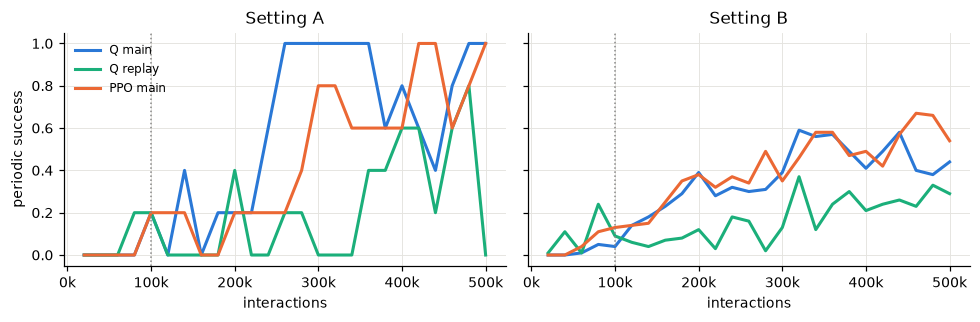
Avevamo previsto (P1) che Q-learning fosse più veloce a 100k. Era sbagliato. Prima idea: Q esplora ancora troppo a 100k (ε = 0.68). Ma anche con ε basso presto resta indietro. Idea alternativa: PPO riusa ogni esperienza ~10 volte, Q una sola. Test: Q-learning con replay (9 aggiornamenti extra per step sugli ultimi 2.000 passaggi). La regola di lettura era scritta prima di lanciarlo: ≤ 0.130 a 100k in B vuol dire che il riuso non spiega la differenza.
Risultato: 0.039 a 100k in B. Quindi il riuso dei dati non spiega perché Q non era più veloce. In più il replay ha peggiorato gli agenti finali (A: 0 su 5 a 500k).
Mostra la figura
runs/diag/{A,B}/q/replay9.5. Dieci episodi (Parte 4)
Abbiamo scelto 10 episodi degli agenti di B con una regola fissa (3 successi tipici, 3 fallimenti tipici, 2 successi sorprendenti dell'agente più debole, 2 fallimenti sorprendenti dell'agente più forte). In ogni episodio guardiamo 3 decisioni. Per ognuna abbiamo ripristinato lo stato del gioco e provato ogni azione 200 volte: così misuriamo la probabilità di successo dopo ciascuna azione. Questo separa "azione sbagliata" da "sfortuna".
- In 4 fallimenti su 5, un'azione negli ultimi step ha trasformato una presa probabile in una perdita probabile (≤ 0.18 mentre un'altra azione dava ≥ 0.67). Il quinto è azione più debole + sfortuna.
- Anche i successi possono contenere errori: PPO 1122 ha vinto dopo un'azione sbagliata.
- Q seed 1 perde due volte nella stessa casella (stato 75) con la stessa azione. Un'altra Q perde lì dove quell'azione era la migliore: una casella mescola situazioni diverse.
- I due agenti più forti (uno Q, uno PPO) falliscono nello stesso punto e allo stesso step: non fermano un paddle che si muove ancora. Nessuna delle 4 feature dà la velocità del paddle.
Limite degli aggregati: un tasso di successo conta tutti i fallimenti uguali, e non mostra se vengono da rumore o da un errore che si ripete.
6. Le nostre previsioni della Parte 1
| Previsione | Esito |
|---|---|
| P1 Q meglio a 100k in A | sbagliata (0.20 vs 0.20) |
| P2 PPO varia di più tra seed | sbagliata |
| P3a entrambi calano da A a B, Q di più | giusta |
| P3b in B il paddle aspetta più vicino alla palla | sbagliata |
| P4a penalità: successo non +5 punti sopra B | giusta |
| P4b meno timeout, episodi più corti in C | sbagliata (timeout mai visti) |
| P5 classifica in training ≠ in valutazione | giusta, ma solo grazie al pareggio in A |
| P6 cambiare raccomandazione se PPO pareggia a 100k in A | condizione verificata: cambiamo |
| S1, S2 comportamento in stati specifici | sbagliate |
| S3 palla in salita, paddle vicino al muro | giusta |
Dopo la consegna abbiamo cambiato la ricompensa (+1 per punto invece di +1 solo al successo), perché il gioco casuale non arrivava mai al successo e l'agente non riceveva nessun segnale. Tutto è documentato in prediction-annotations.md.
7. Raccomandazioni (Parte 6)
Demo in classe → Q-learning, 500k step, setting A. Entrambi risolvono A, Q costa meno tempo e la sua politica è una tabella 169 × 4 che si può mostrare. Debolezza: a fine training è instabile, e molti Q-value sono quasi pari.
Uso ripetuto con incertezza → PPO, 500k step, in B senza penalità. Meno fallimenti in B (dentro una std, ma ripetuto con seed nuovi 5–9: 0.44 contro 0.54) e in C (oltre una std, agenti allenati a parte). La condizione per passare a Q con ε decay 500k è stata testata con seed nuovi e non è soddisfatta (0.41 ± 0.15). Non diciamo più "meno sensibile agli iperparametri": con lr 3e-4 PPO scende a 0.22. Supporto solo relativo: fallisce ancora ~45% degli episodi, e nel tuning Q era davanti.
Dopo un cambio dell'ambiente → nessun agente è abbastanza supportato. In D, su 10 agenti, i due sono pari (0.36 e 0.35): il vantaggio di PPO sui seed 0–4 non si ripete con seed nuovi. Se serve, PPO con monitoraggio dei fallimenti, perché è migliore prima del cambio e non peggiore dopo; ma perde di più nel cambio (tiene il 65% del successo in B, Q il 75%).
Non diciamo mai che un algoritmo è migliore in generale. I numeri valgono per questa implementazione (Breakout, 169 caselle, SB3, 500k step, 5 seed).
8. Punti deboli da conoscere
- In B la differenza PPO–Q è circa mezza std, e nel tuning (altri seed) l'ordine era invertito.
- "Manca la velocità del paddle" viene da due episodi: non l'abbiamo testato aggiungendo la feature.
- Le configurazioni scelte stanno sul bordo della griglia di tuning (Q: lr più basso, calo di ε più lungo; PPO: lr più alto).
- Abbiamo testato un solo tipo di replay e un solo tipo di cambio dell'ambiente.
9. Per il meeting di giovedì
Prima del meeting (10 minuti, da soli): leggete evidence-brief.pdf e scrivete per ognuna delle 4 domande il punto che vi sembra più importante:
- la prova più forte a supporto delle conclusioni;
- un'affermazione che va oltre le prove;
- una spiegazione alternativa;
- il confronto con le nostre previsioni.
Al meeting: confrontiamo le note, scegliamo una risposta per domanda e annotiamo chi ha detto cosa e dove non siamo d'accordo. Da lì scriviamo il review record della Parte 5 (max 1.000 parole). Deve venire dalla nostra discussione, non può essere inventato.
Ancora da fare
- Review record della Parte 5 (traccia e spunti in
part5-review-material.md). - Completare i punti
[TEAM: ...]inai-assistance.md. - Decidere il formato di consegna (zip o file separati, markdown o PDF).
Dove trovare le cose nel repo
| File | Contenuto |
|---|---|
evidence-brief.pdf | Il documento principale (Parti 2, 3, 4, 6). |
analysis.ipynb, figures/ | Tutte le tabelle e figure, lette dai log. |
runs/ | Log grezzi, config e seed di ogni run. |
env.py, agents.py, run.py | Il codice. Comando unico in README.md. |
part1-predictions/, prediction-annotations.md | Previsioni originali e note datate. |